

Hace unos días, revisando archivos viejos, David Martínez Mata se encontró con una fecha: 9 de febrero de 2019. Bromeó con que la presentación parecía el título de una película postapocalíptica. Era el día de la primera auditoría SEO que hizo para una universidad, una institución que todavía hoy es cliente de nuestro equipo en LC.
El encargo sonaba sencillo y resultó enorme: rastrear, clasificar y darle sentido a los más de 150.000 archivos que la universidad había acumulado en su sitio web. Hasta ese momento, David venía del comercio electrónico y de sitios de marcas B2B en Estados Unidos. La universidad era otra criatura. Nadie sabía bien cómo se había construido la información ni con qué criterio se clasificaba.
Desde entonces, esa pregunta «cómo ordenar lo que una institución ha publicado durante décadas» lo ha acompañado. Y ese fue también el hilo de la conferencia que dio en AcademIA Summit 2026.
David Martínez Mata es director de SEO en Los Creativos. Con más de diez años de experiencia en posicionamiento, lidera los proyectos de SEO y rediseño web de la agencia. Es comunicador social con énfasis en periodismo y pasó dos años estudiando en Europa. Allí cursó un máster hispanofrancés en Lengua Francesa Aplicada en la Universidad Complutense de Madrid y un máster en FLE y Ciencias del Lenguaje en Sorbonne Université. En ese camino se acercó a la lingüística computacional, la disciplina que estudia cómo las máquinas interpretan un texto para producir respuestas.
Sigue de cerca la conferencia de David y lo que divulgó en la charla:
- Esa doble mirada, la del técnico que audita miles de URL y la del lingüista que se pregunta cómo lee una máquina, está detrás de dos trabajos que alimentaron su charla. El primero es la metodología de densidad de señales, que diseñó en Los Creativos junto con Juan David Uribe, director de estrategia de la agencia, quien presentó esa metodología en el mismo evento.
- El segundo es un experimento con dos sitios web gemelos que terminó contradiciendo su propia hipótesis. De ese tropiezo surgió el modelo que hoy propone para las universidades: las páginas agrupadoras.
Para David Martínez Mata, el problema de visibilidad de una universidad en Google o en ChatGPT empieza mucho antes de escribir el próximo artículo del blog. Empieza en lo que ya está publicado y nadie ha ordenado.
¿Qué fue lo que propuso?
David planteó una idea que incomoda a quien vive de producir contenido: buena parte de lo que una universidad necesita para ser visible ya está publicado, solo que enterrado. Sostuvo que Google, YouTube o ChatGPT saben poco de una institución, porque trabajan con una representación armada a partir de años de contenido acumulado.
Luego organizó la charla en tres relatos:
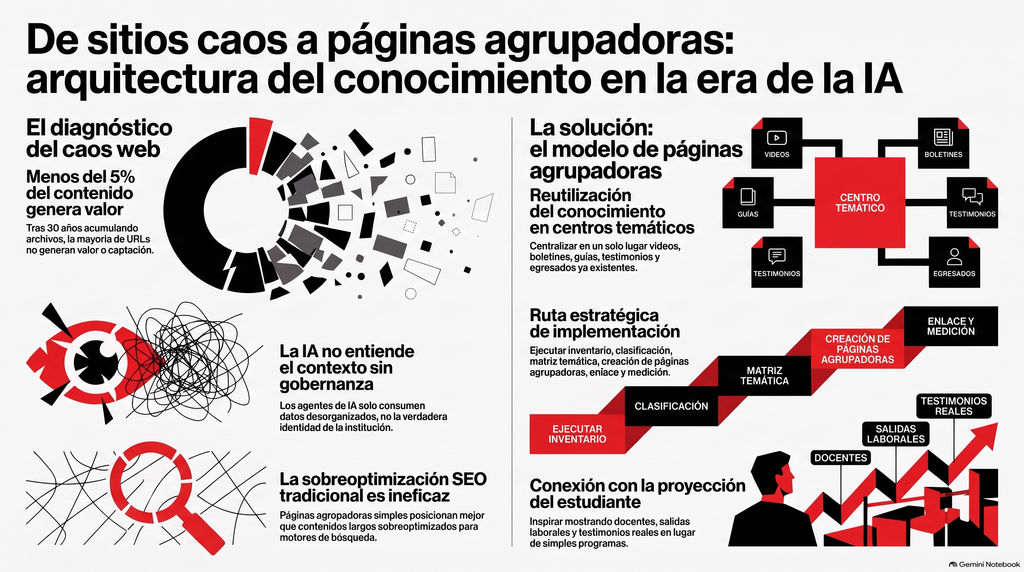
- En el primero, el reino del caos, mostró los resultados de auditorías a tres universidades, con nombres cambiados: sitios donde la mitad del contenido son imágenes o PDF, donde hasta una tercera parte de las URL está rota y donde la oferta académica ocupa una porción mínima del total. Advirtió que el origen del problema está en la ausencia de políticas de gobierno de la información.
- En el segundo relato contó un experimento con dos sitios web gemelos sobre escuelas de idiomas en Francia. Uno se escribió bajo un protocolo lingüístico estricto y el otro sin instrucciones. Reconoció que el resultado lo descolocó: ganó el sitio sin optimizar, y la página más citada en ambos fue una agrupadora con apenas dos párrafos.
- De ese hallazgo nace el tercer relato, el modelo de páginas agrupadoras. Propuso reunir, por facultad o por área de conocimiento, lo que la universidad ya tiene disperso: programas, videos, boletines, reseñas, perfiles de egresados, notas de prensa y divulgación de sus investigadores. Insistió en que un aspirante busca inspiración y respuestas sobre su futuro, además de datos del programa. Detalló un proceso de ocho pasos, del inventario a la medición, y matizó que el trabajo toma meses y exige decisiones entre varias áreas.
Cerró con una advertencia hablado de la sobreoptimización. En su lectura, los modelos de IA trabajan con relaciones de cercanía entre conceptos, así que la respuesta depende cada vez más de cómo se ordena y se divulga lo que ya existe.
Lo que nos interesa en la voz de David Martínez Mata
La charla avanzó como una historia en tres capítulos. Aquí está su voz, acompañada de algunas explicaciones para quien no estuvo en AcademIA Summit 2026.
Lo que la IA sabe de ti se parece a un perfil de Facebook
Martínez Mata arrancó preguntando qué saben de una universidad sus aspirantes, su comunidad, YouTube, Google y, más recientemente, ChatGPT. Su respuesta fue seca: “saben muy poco o nada”.
Para explicar por qué, recurrió a una comparación de la vida cotidiana:
“Hace unos años uno conocía a una persona por Facebook. Uno asumía su nombre, su foto y sus intereses, y cuando la conocía en persona era muy distinta: hablaba más, era más alta, era más delgada. Con la arquitectura de la información pasa lo mismo. Lo que saben los agentes de IA sobre ustedes es la información que han consumido durante los últimos años, y eso no necesariamente coincide con lo que ustedes son.”
La idea tiene una consecuencia incómoda para cualquier institución con historia. Si lo que la IA y los buscadores conocen es lo que lleva años en los servidores, la imagen que devuelven es la del archivo acumulado, con todo su desorden. El conferencista lo planteó como un dilema de identidad: “Si esa institución que aparece no soy yo, si no me representa todo lo que he estado cargando de contenido, entonces ¿quién soy yo? ¿Qué me representa?”.
El reino del caos
Así tituló el primer relato, y así lo justificó:
“Un sitio web, por naturaleza, es un caos. La tecnología lo aguanta; el desorden lo ponemos los seres humanos, que manejamos el contenido de formas que a veces no son tan lógicas o no funcionan tan bien. Cuando uno mira los dominios de las universidades más grandes del país, encuentra sitios que llevan décadas acumulando contenido. ¿Cuántas tienen a alguien encargado de administrar ese conocimiento durante todo ese tiempo? Y eso es solo el dominio principal: los subdominios de revistas o de investigación son otros universos.”
Para demostrar que no exageraba, mostró tres auditorías hechas por él a universidades reales, rebautizadas como Universidad de las Ciencias Básicas, Universidad de la Salud y Universidad del Derecho.
“Una tiene 106.000 URL, otra 11.895 y otra 7.000. Para tener contexto, imagínense una bodega con 106.000 libros sin clasificar. No saben si son de filosofía o de ingeniería, y tienen que encontrar ahí el que les interesa.”
Adentro, el panorama era este:
“En la primera, el 69 % de las páginas son de contenido tradicional. En la segunda, el 49 % son imágenes: la mitad del sitio. En la tercera, el 53 % son PDF. Más de la mitad de esa web son documentos guardados en una carpeta que nadie visita: ni Google, ni ChatGPT, ni los usuarios.”
Una URL es la dirección de cada página o archivo en internet. Cuando una dirección envía a otra, y esa a otra más, sin llegar nunca a destino, se habla de un bucle de redirecciones. Cuando lleva a una página que ya no existe, el navegador muestra el conocido error 404. Ambos problemas aparecieron en las auditorías:
“En el primer sitio, el 36 % de todas las páginas tiene bucles de redirecciones. En el segundo, el 13,5 % son errores 404, páginas que no existen: el usuario entró, no vio nada y se fue. El tercero es peor: el 35 % del sitio son páginas 404.”
Luego vino el dato que más le pesa a una oficina de admisiones, cuánto de todo ese volumen habla de la oferta académica:
“En el primero, solo el 0,2 % son URL de pregrados, posgrados, doctorados y admisiones. En el segundo es el 2 % y en el tercero, el 4,6 %. Si analizamos los tres, menos del 5 % de un sitio web universitario sirve para captar estudiantes o para generarles valor.”
Según sus auditorías, alrededor de cada programa casi no hay contenido de apoyo, como guías de financiamiento o salidas profesionales. En una de las universidades, algunos programas tienen uno solo. “Al programa le toca ir a la batalla contra un montón de universidades con un único contenido, porque la estructura del sitio no está hecha para ayudarle a ser relevante”, resumió.
Archivos que se llaman “document”
David cree que muchos de esos documentos podrían servir para atraer estudiantes y también para divulgar ciencia, pero nadie los encuentra porque nadie sabe qué contienen. Basta ver cómo se llaman:
“En el primer sitio, casi el 80 % de los PDF no tiene título: se llaman con una cadena de números. En el segundo se llaman ‘document’. En el tercero, algo como ‘autoadmit’ seguido de otra serie de números. No hay forma de entender de qué trata un documento así, y son miles. Todo vive en carpetas como ‘comunicaciones’ o ‘wp-content’, la de WordPress, donde se ha almacenado durante décadas. Las imágenes se llaman ‘WhatsApp image’ con una fecha y una serie de letras.”
De ahí llegó a la raíz del asunto:
“Cuando una universidad pregunta por qué no la menciona la IA o por qué Google no la muestra de primera, la respuesta empieza en la gobernanza de la información. No hay políticas de gobierno de la información. Y esto rebasa el SEO. Lo que está en juego es cómo construyo conocimiento con el sitio web de mi universidad, de mi colegio, de mi institución académica.”
Con ese diagnóstico, el conferencista resumió tres problemas iniciales para cualquier estrategia de contenidos: la clasificación, el nombre de los archivos y las URL rotas, que en sus auditorías oscilaron entre el 13 % y el 36 % del total. Sobre la clasificación dejó una paradoja que volvería al final de la charla: “La IA entiende mucho mejor que yo y que mi universidad todos los documentos que tengo, pero no entiende el contexto de esos documentos o de esas páginas. Yo sí entiendo el contexto, pero no sé cuántos son ni dónde están”.
La página que nadie quiso escribir
El segundo relato es el más personal. La pregunta que lo persigue desde aquella auditoría de 2019, cómo ordenar el contenido para transmitir mejor el conocimiento a las máquinas y a los humanos, lo llevó a estudiar en Europa y a diseñar un experimento.
“Esa pregunta fue el detonante de mis estudios de posgrado en Europa, en lingüística computacional. Ahí hice un experimento con algo que llamé protocolo de explicitación semántica.”
Fueron dos sitios web con el mismo número de páginas, lanzados el mismo día, en el mismo servidor y con la misma estructura. Ambos se escribieron con IA y ambos trataban sobre las mejores escuelas de idiomas en ciudades de Francia, en francés, la lengua de su maestría en la Sorbona. Cada sitio tenía una página de inicio, una página que agrupaba las ciudades y una página por ciudad, con reseñas reales de cada academia. La diferencia estaba en las instrucciones que recibió la IA.
“El protocolo dice cuántas palabras clave se van a usar, cómo y dónde, cómo va a ser la estructura del contenido y cuántas palabras va a tener. En el mundo del SEO uno habla mucho de palabras clave; en el de la lingüística se habla de hiperónimos, sinónimos, etcétera. El primer sitio se creó bajo un control estricto, con unas validaciones que tenía que pasar. El segundo solo tenía una indicación: ‘crea un contenido que hable sobre esto’. Nada más.”
Un hiperónimo es la palabra general que abarca a otras más específicas, como “escuela de idiomas” frente a “curso intensivo de inglés”. El protocolo obligaba a usar esas relaciones y los sinónimos de forma deliberada y medible. Ambos sitios, eso sí, se alimentaron de opiniones reales:
“Extrajimos de Google Maps las reseñas de 130 escuelas en Francia: casi 1.000 opiniones de usuarios reales sobre esas academias.”
Antes de mostrar los resultados, Martínez Mata le preguntó al auditorio cuál de los dos sitios creía que había funcionado mejor.
“El que mejor funcionó fue el que no tenía el protocolo. La cara de sorpresa también la tenía yo, porque mi hipótesis inicial era otra. Llevo un montón de años haciendo SEO. ¿Cómo iba a ser que el sitio sin optimización funcionara mucho mejor que el optimizado?”
Los resultados están documentados en el informe del experimento publicado por Los Creativos. En Google, el sitio sin protocolo tuvo casi el doble de impresiones que el optimizado. Frente a la IA, la brecha fue mayor: según la sección de rendimiento en IA de Bing Webmaster Tools, que reporta cuántas veces un sitio aparece como fuente en las respuestas de Copilot, el sitio libre sumó 118 citaciones y el optimizado, 9. Martínez Mata agregó que en Perplexity la tendencia se repitió:
“Cuando analizo las respuestas que daba la inteligencia artificial a preguntas como ‘mejores escuelas de idiomas en París’, el que no tenía optimización funcionó mejor que el mío. Eso me dejó preguntándome: ¿será que estamos forzando la optimización del contenido? Tal vez la IA entiende mucho mejor. La representación que tiene sobre mi contenido, sobre una industria, es mucho mejor que la que tengo yo sobre un contenido concreto.”
Una página de dos párrafos se llevó las citas
El experimento guardaba un segundo golpe a sus certezas. Martínez Mata esperaba que las páginas de cada ciudad, con artículos largos y completos, fueran las más visibles.
“La página que mejor posicionó en ambos sitios fue la agrupadora. No fue ninguna de las ciudades ni el inicio. Y esa página agrupadora casi no tiene contenido: tiene dos párrafos. Hablamos de unas 600 palabras frente a las casi 4.000 de los artículos.”
En el informe publicado, esa sección agrupadora del sitio sin protocolo concentró 65 de sus 118 citaciones en Copilot. Para alguien que lleva años recomendando contenido extenso y optimizado, el dato pedía una revisión honesta:
“Si la hipótesis es que el contenido optimizado y creado perfectamente funciona mejor, y que el contenido más extenso funciona mejor, las dos se caen. ¿Qué podemos hacer, si eso es lo que vendemos desde hace un montón de años? Tengo muchos proyectos de universidades donde reina el caos, y tengo una página agrupadora a la que citan más que a los artículos. De ahí nace una estrategia que creamos para las universidades: el modelo de páginas agrupadoras.”
Domar el caos
El tercer relato empezó con un recuerdo de cuando eligió dónde estudiar:
“Un estudiante, además de recibir información sobre un programa, necesita que alguien lo inspire. Cuando yo quería entrar a la universidad, me sentía inspirado por gente que había estudiado allí. Yo decía: ‘Esa persona hace eso, yo quiero hacer eso, y por eso voy a estudiar ahí’. Me movían los profesores que hacían cosas que yo quería hacer. Las estrategias de contenido tienen una falencia: se centran en el programa y dejan de lado cómo se proyecta el estudiante durante la carrera o cuando se gradúe.”
Sobre el desorden fue realista: nunca va a desaparecer, porque cada área, de comunicaciones a investigación, sube contenido según sus necesidades. Eso le parece normal. El problema, dijo, es otro:
“No hay forma de agruparlos. Una universidad tiene PDF, imágenes, programas, eventos, investigadores con productos científicos y de divulgación. Toda esa información está desagrupada. Entonces, si mi experimento me indica que la página que mejor funciona es la agrupadora, ¿por qué no agrupar el contenido de una manera fácil de rastrear? La importancia de esa página está en el contenido que agrupa.”
Cómo se ve una página agrupadora
Mostró como ejemplo la página que Los Creativos dedica al sector educativo, con sus metodologías, casos, podcasts y preguntas frecuentes. Pero el caso que mejor se entiende es el de una facultad de salud:
“Imagínense una gran página agrupadora de ciencias de la salud. Reúne las carreras que ofrece la universidad, medicina, enfermería, y sus especializaciones. Tiene un comparador de esas carreras y rutas de formación: si hago un pregrado, cómo hago después un posgrado. Tiene los videos de YouTube, TikTok e Instagram que la universidad ya publicó sobre el área: un día de prácticas en medicina, cómo es una residencia médica. Tiene planes de estudio, guías de admisión y boletines de la facultad. Tiene lo que dicen los estudiantes, porque todas las universidades tienen una ficha de Google Business Profile con cientos o miles de reseñas. Y muestra quiénes son los egresados y sus perfiles de LinkedIn, porque yo, como estudiante, quiero saber qué hacen y en qué trabajan.”
La clave del modelo llegó justo después:
“Todo ese contenido ya existía. No se creó nada nuevo, nada. Estaba guardado en un sitio web durante años, sin utilizarse. Por eso, cuando hacemos estrategias de contenidos, yo digo: paremos un momentico. No hagamos contenido nuevo; empecemos a usar lo que ya tenemos. Todo recurso en internet tiene una URL, es rastreable, es indexable y se puede encontrar.”
Y no tiene que ser una sola página por facultad:
“Si tengo 2.000 o 3.000 boletines, los puedo agrupar por fechas y también por categorías: investigación, prácticas, egresados, internacionalización.”
La razón comercial, para él, es directa. Un aspirante suele empezar buscando la carrera y llega a la universidad después:
“Cuando el estudiante quiera ver todo lo que ofrece la universidad en esa facultad, lo va a encontrar ahí. Seguramente le va a preguntar a ChatGPT, y probablemente la página agrupadora va a ser más citada que la de la carrera, porque de entrada el estudiante busca por qué estudiar esa carrera, cuánto cuesta estudiarla en Colombia, cuáles son las salidas laborales, quiénes son los profesores y qué puede hacer después de graduarse.”
Hay además un detalle práctico: el modelo deja intacta la plataforma tecnológica.
“Hacer esto desde la estructura del sitio web sería supercomplejo: tradicionalmente requeriría un rediseño que puede tomar uno o dos años. Este modelo reestructura la arquitectura de conocimiento de la universidad, agrupando en distintos lugares la información más relevante.”
8 pasos para ordenar la casa
El método empieza por una pregunta que pocas universidades saben responder: qué tan grande es su sitio. Cuántos subdominios y revistas tiene, cuánto contenido corresponde a cada área y a cada nivel de formación, y cuánto a la vida institucional. Extraer todas las URL con una herramienta de SEO, aclaró, es la parte fácil.
“La parte difícil es saber cuáles son páginas, cuáles son PDF, infografías, videos, casos, preguntas. Eso requiere una matriz de conocimiento. Y una sola persona no puede hacerlo. Ni siquiera con IA: la IA sabe cuáles son los recursos, pero no los interpreta. Yo sé que hay PDF de universidades con cero tráfico que tratan aspectos legales muy relevantes y que deben vivir en un lugar de la universidad. La IA no sabe eso.”
Con esa matriz como herramienta, el proceso que describió tiene ocho momentos:
- Hacer el inventario de los recursos, normalmente en una hoja de cálculo.
- Clasificarlos por tipo, categoría, área, fecha, interés, departamento o relación.
- Definir las categorías según cada público: estudiantes, investigadores, profesores, egresados, área legal, TI y personal administrativo.
- Identificar los subtemas concretos de cada categoría.
- Llenar la matriz, una vez definida en lo conceptual la arquitectura del conocimiento.
- Crear las páginas agrupadoras a partir de las similitudes entre recursos.
- Publicar y enlazar lo que ya existe, y crear contenido nuevo donde la matriz muestre vacíos.
- Medir.
Martínez Mata advirtió que nada de esto se resuelve en una semana: “Esto toma semanas y meses, porque las decisiones se toman entre varias personas, según el objetivo y la filosofía de la universidad”. La medición, agregó, tiene dos vías: la captación de estudiantes y la divulgación de la ciencia.
En la práctica, eso implica renombrar archivos, construir fichas, decidir desde dónde enlazar e incrustar los recursos en cada carrera. Sobre esto último fue enfático:
“Yo audito universidades casi todos los días, y siempre me gustaría encontrar a alguien que me dijera qué voy a hacer cuando me gradúe de esa carrera. Muchas universidades me han dicho que esa información no se puede publicar porque cambia, o por políticas internas. Para mí son patrones un poco acartonados, y esa información incrustada por carrera es lo que hace la diferencia en una estrategia para traer estudiantes.”
Los profesores, los medios y la segunda vida del contenido
La agrupación también puede mirar hacia afuera, a lo que la prensa ya publicó sobre la universidad:
“Imagínense todo lo que han dicho los medios sobre una universidad. Eso es PR digital, y ya está publicado. Si le doy una segunda vida y lo agrupo en un lugar donde los estudiantes puedan encontrar qué han dicho sobre mí, lo bueno, lo regular y, según el caso, lo malo, también le estoy dando contenido al usuario. Y los investigadores que hacen parte de los grupos de investigación publican papers y tienen contenidos de divulgación. ¿Por qué no traerlos a esa página agrupadora?”
Para él, el mundo digital gira cada vez más alrededor de las personas que forman parte de las instituciones, y en internet el contenido de una persona puede pesar más que el de una universidad completa:
“Para mí, los mejores influenciadores de una universidad son sus profesores. No estoy diciendo que salgan a hacer videos en TikTok. Lo son porque divulgan su área de conocimiento. Un profesor puede pertenecer hoy a una universidad y mañana a otra, pero la pasión y la divulgación trascienden la universidad.”
El rey, la reina y el gato
Al final, el conferencista volvió sobre el experimento para explicar por qué perdió el texto forzado. Durante años, el SEO calculó cuántas palabras clave y enlaces insertar en cada página. Hoy el contenido tiende a ser más natural, por la forma en que los modelos procesan el lenguaje:
“Un agente de IA no entiende el lenguaje como nosotros: está entrenado para encontrar relaciones. En un vector de distintas dimensiones busca la cercanía probabilística. Sabe que la palabra ‘rey’ está muy cerca de la palabra ‘reina’ y muy lejos de la palabra ‘gato’. Como entiende las relaciones de forma probabilística, la idea es encontrar una arquitectura que nos permita simular las relaciones entre las dimensiones de mi universidad dentro de un ecosistema de conocimiento.”
El ejemplo tiene raíces en la investigación sobre representaciones vectoriales de palabras. En un artículo presentado en 2013, Tomas Mikolov, Wen-tau Yih y Geoffrey Zweig mostraron que, en esos vectores, la operación “rey menos hombre más mujer” da un resultado muy cercano a “reina”.
La respuesta ya está en el archivo
Finalmente, David dejó cuatro ideas. La primera retomó la comparación con Facebook del comienzo:
“Lo que sabe la IA sobre mí es una interpretación de todo lo que he subido a esa web durante años, que puede no parecerse en nada a lo que hago hoy. Todas esas webs tienen varias capas, una sobre otra, de gente que las ha administrado. Si yo quiero que la IA me interprete de la forma en que quiero, necesito construir y clasificar todo lo que tengo, y crear una estrategia de arquitectura del conocimiento para divulgar.”
La segunda fue una advertencia para quienes ya empezaron a ordenar: “Clasificamos el contenido, lo tenemos en páginas agrupadoras, pero tampoco se usa, no se divulga ni se relaciona con las áreas de la universidad. Tengo que determinar qué voy a hacer con el contenido que clasifico”.
La tercera fue la sobreoptimización, que ya había explicado con el rey, la reina y el gato.
La cuarta resume su apuesta, y fue lo último que dijo antes de dar las gracias:
“Cada vez la respuesta depende menos de lo que voy a publicar en el futuro. El trabajo real de hacer la arquitectura de contenidos está en lo que tenemos hoy: cómo lo agrupamos y cómo lo divulgamos.”
La próxima vez que una universidad se pregunte por qué ChatGPT no la recomienda, la charla de David Martínez Mata sugiere empezar por el archivo: los PDF sin título, los boletines olvidados, las reseñas y los videos que ya existen. Ordenarlos toma meses y exige decisiones entre varias áreas, pero el material está ahí, esperando una página que lo reúna y le dé sentido.
Quien quiera revisar los datos puede leer el informe del experimento publicado por Los Creativos. La conferencia completa está en YouTube
Preguntas frecuentes sobre la conferencia de David en AcademIA Summit 2026
¿Qué es una página agrupadora?
Es una página que reúne en un solo lugar los recursos que una universidad ya tiene dispersos sobre un tema o una facultad. Puede incluir programas, comparadores de carreras, videos, guías de admisión, boletines, reseñas, perfiles de egresados y notas de prensa. Para David Martínez Mata, su valor está en lo que conecta, aunque ella misma tenga poco texto propio.
¿Por qué la IA citó más una página agrupadora que los artículos extensos?
En el experimento de Martínez Mata, la página que agrupaba las ciudades tenía apenas dos párrafos y aun así fue la más visible en los dos sitios. En el sitio sin protocolo concentró 65 de las 118 citaciones en Copilot, según el informe publicado. Su lectura es que los modelos reconocen mejor el contenido cuando está organizado y relacionado entre sí.
¿Hay que crear contenido nuevo para armar una página agrupadora?
No necesariamente. En el ejemplo de ciencias de la salud que mostró el conferencista, todo el contenido ya existía en el sitio y en las redes de la universidad. Su recomendación es usar primero lo que ya está publicado y crear piezas nuevas solo donde la matriz de conocimiento muestre vacíos.
¿Cómo se empieza a ordenar el contenido de una universidad?
David Martínez Mata propone ocho pasos:
- Hacer el inventario de los recursos.
- Clasificarlos.
- Definir categorías para cada público.
- Identificar los subtemas de cada categoría.
- Llenar la matriz de conocimiento.
- Crear las páginas agrupadoras.
- Publicar y enlazar.
- Medir.
¿Optimizar un texto con muchas palabras clave ayuda a aparecer en la IA?
El experimento de Martínez Mata apunta en sentido contrario. El sitio escrito bajo un protocolo lingüístico estricto tuvo menos citaciones y menos impresiones que el sitio redactado sin instrucciones. Él lo atribuye a que los modelos funcionan por cercanía entre conceptos, así que un texto natural y bien conectado comunica mejor que uno forzado.

Eddie Vélez Benjumea (1993) es periodista, escritor y especialista SEO Senior en Los Creativos, donde ha diseñado estrategias de contenido para marcas como Bancolombia, Grupo Éxito, UPB y la Alcaldía de Medellín. Autor de tres libros publicados —Inmarcesible (2021), La vida en un soplo (2022) y Elogio de la penumbra (2024). Algunos de sus textos han aparecido en El Espectador, El Colombiano y antologías de Colombia, Argentina, España y México. Certificado en Content Marketing por HubSpot. Une el rigor técnico del SEO/GEO/AEO con la precisión de la literatura y la gramática.