Recuerdo, como si fuese ayer, el día en que hice mi primer keyword research para una estrategia de SEO. Corrían los días de febrero de 2017 y apenas podía discernir entre la avalancha de términos y definiciones que arrojaban mis más experimentados colegas del mundo del posicionamiento en motores de búsqueda.
Aquella investigación de palabras clave, extrañamente adictiva y placentera, me tomó un día entero; no por su complejidad, sino por la abundante cantidad de información que exponía y de la cual debía extraer lo más importante para optimizar el sitio web de un importante centro de idiomas con franquicias en todo el mundo.
Inicialmente emocionante, a medida que avanzaban las horas todo ese proceso: la clasificación de las palabras clave, el discernimiento entre cuáles eran las más aptas para el proyecto, la batalla de los volúmenes de búsqueda, la disyuntiva de la dificultad de posicionamiento y la avalancha de keywords secundarias que escupía el Keyword Planner de Google Ads convirtió el ejercicio en un desorientado intento de clasificar y justificar mis hallazgos; eso que los anglosajones llaman un rabbit hole.
Algunas semanas después, una tarea similar llegó a mi escritorio, pero a diferencia de la anterior, ahora me entregaban la llave de una nueva herramienta: Ahrefs. Si el Keyword Planner despertaba mi obsesión por clasificar, créanme que esta conocidísima herramienta de SEO me llevó a otro nivel de agitación.
Por un lado, entregaba gráficos de tráfico orgánico estimado, la evolución de las palabras clave por posición, clics orgánicos frente a clics de pago, análisis de la intención de búsqueda según el tipo de término, entre muchas otras funcionalidades; por otro, ese gran núcleo de datos me hundía nuevamente en el complejo proceso de elegir los mejores términos para una estrategia.
Casi diez años después, ya con más horas de vuelo y con más pericia piloteando proyectos de posicionamiento web, veo a colegas que se inician en este oficio enfrentando los mismos retos, pero con un universo de opciones que supera con creces el que yo conocía cuando empecé a hacer SEO: existen ahora más herramientas, mayoritariamente relacionadas con agentes de inteligencia artificial que, además de extraer keywords y clasificarlas, entregan análisis, contexto y oportunidades para sacarles provecho en un proyecto digital.
No obstante, hay tres situaciones que persisten y que, a mi juicio, son los retos más relevantes de una investigación de palabras clave:
- Cómo extraer y clasificar los términos de búsqueda: por intención de búsqueda, por dificultad, por volumen, por tráfico potencial y por costo por clic.
- Cómo elegir las palabras clave correctas: de la vasta cantidad de términos posibles a partir de una keyword principal, ¿cuáles podrían ser la mejor opción para cada una de las páginas de alto impacto (PAI) que intentamos posicionar y visibilizar en agentes de IA? A modo de ejemplo, solo la búsqueda «aprender inglés» arroja 12.800 términos asociados en Colombia en Ahrefs.
- ¿Cuál debería ser el volumen de búsquedas de un «buen término»? El eterno debate no tiene una respuesta única; siempre depende del contexto: el nicho de mercado, los competidores de ese segmento, la inversión disponible para la estrategia de SEO, entre otras variables.
Responder las dos primeras preguntas, al menos antes de la irrupción masiva de los agentes de inteligencia artificial, habría supuesto lo siguiente:
- Listar los productos o servicios más relevantes de nuestro cliente.
- Comprender en qué países, ciudades e idiomas se implementaría la estrategia.
- Asignar a cada producto o servicio un término clave.
- Buscar cada término, asociado a una URL, en herramientas como Ahrefs, SEMrush, Ubersuggest, Keyword Planner o Mangools.
- Descargar todas las keywords asociadas a cada término y crear una pestaña para cada uno.
- Según la experticia del especialista, filtrar la hoja de cálculo por intención de búsqueda (informacional, transaccional, mixta, etc.) y asignar una afinidad, ya sea por volumen o por tipo de producto.
- Hacer una selección final de entre 10 y 20 términos, que se distribuirían a lo largo del texto en:
- Metatítulos
- Metadescripciones
- Encabezado principal H1
- Encabezados secundarios H2
- Anchor texts para enlaces internos
- Nombres de imágenes
- Preguntas frecuentes
La necesidad de clasificar y nombrar
Esta rutina es parte —todavía— del entrenamiento diario de un especialista en SEO y arquitectura del conocimiento que busca comprender las complejidades, oportunidades y brechas de las palabras clave de su industria.
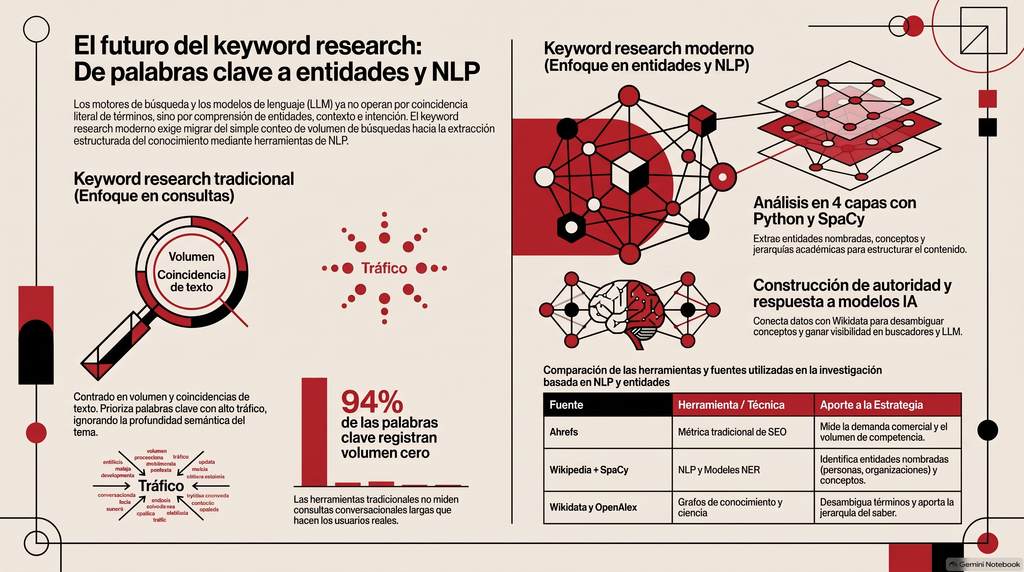
El reto que presenta, más allá de la metodología, es que los motores de búsqueda y los agentes de IA ya no operan principalmente a partir de la coincidencia literal de términos, sino a partir del significado, la intención y las entidades que subyacen a cada consulta. El SEO moderno exige investigar las relaciones en el nuevo reino del significado: mapear intenciones, problemas y clústeres temáticos, y anticipar qué preguntas complejas y matizadas no pueden responderse con una sola frase.
¿Para qué sirve una keyword?
“En el SEO moderno, una keyword es un término que nos permite comprender la demanda de productos y servicios relacionados con ella, la dificultad potencial de posicionamiento asociada y las acciones necesarias para atraer clientes o visitantes desde un motor de búsqueda, una plataforma social o un agente de IA”.
Esa definición delimita el territorio del SEO moderno frente a lo que en algún momento se consideraba (y todavía se considera) spam: repetir de manera casi criminal un conjunto de términos con la esperanza de posicionar mejor, en lugar de crear lo que Google llama «contenido útil, fiable y centrado en las personas».
Cada vez más, los especialistas, las agencias de marketing y los equipos de comunicación se alejan del contenido escrito para los buscadores y se orientan a prácticas orientadas a destacar, visibilizar y expandir la experiencia y la experticia de una marca mediante una correcta densidad de señales.
En esa disputa entre escribir para la máquina y escribir para las personas, Google, hasta cierto punto, ha ganado la batalla. Los motores de búsqueda dejaron de ser sistemas de coincidencia literal hace mucho tiempo: hoy sus modelos entienden la intención, el contexto, las relaciones semánticas entre conceptos y las variaciones de una misma idea sin necesidad de que aparezca exactamente la palabra que escribió el usuario. Desde Hummingbird (2013) y RankBrain (2015), y con mayor profundidad desde BERT (2019) y MUM (2021), un buscador procesa el lenguaje natural replicando —o al menos intentándolo— lo que haría un lector al crear relaciones: busca el significado detrás de la cadena de caracteres, no la cadena en sí.
Google dejó de premiar la coincidencia exacta
«…Con nuestro sistema de dominios de concordancia exacta nos aseguramos de no dar demasiado valor al contenido alojado en dominios diseñados para coincidir exactamente con consultas concretas. Por ejemplo, alguien podría crear un nombre de dominio que contenga las palabras ‘mejores-sitios-para-comer’ con la intención de que el contenido obtenga un mejor posicionamiento. Nuestro sistema se adapta a estas situaciones.»
— Guía sobre los sistemas de posicionamiento de la Búsqueda de Google
Como el buscador cambió, quienes nos dedicamos a este oficio también nos hemos adaptado, aunque mucho más lentamente que los cambios que ocurren cada día.
Hoy es un debate acalorado hablar de SEO y GEO. Muchos aseguran que la Generative Engine Optimization es SEO con otro nombre; otros, más tímidos, afirman que es una disciplina con dinámicas propias.
Lo que sí es cierto es que seguimos usando técnicas pensadas para un mundo gobernado, hasta hace poco, por los motores de búsqueda, y el keyword research es la más emblemática. Me atrevo a decir que la propia velocidad con la que se nos exigen estrategias, tácticas y resultados nos deja poco margen para replantear la herramienta con la que empezamos casi todos los proyectos.
Y eso debe cambiar.
Porque si algo nos ha dado la irrupción de los grandes modelos de lenguaje (LLM), es un nuevo ecosistema. Hoy estamos ante El Aleph de Jorge Luis Borges, ese pequeño punto en el espacio que contiene todos los puntos del universo. La diferencia es que un LLM no te da acceso al conocimiento, sino a una representación estadística de este. Y esa representación está gobernada por lo que más se ha dicho sobre un tema (probabilidad), por cómo se ha dicho (lingüística) y por quién lo ha dicho (autoridad).
Buscando aportar a ese cambio, lo que sigue muestra otra forma de abordar una investigación de palabras clave. Sin dejar de lado el aspecto transaccional, hoy el contexto exige profundidad y autoridad.
Los motores de búsqueda evolucionaron
Los primeros sistemas de recuperación de información eran literales. Si escribías «agencia de marketing Medellín», buscaban exactamente esas palabras en los documentos; si alguna de ellas faltaba, el documento no existía.
Este es un comparativo de modelos de recuperación de información según sus capacidades y limitaciones. La elaboración propia a partir de«Evolving Information Retrieval: From Traditional Models to Emerging Paradigms», un paper escrito por Ibrahim Atoum, profesor de la Facultad de Ciencias de la Información de la Universidad de Jordania.
| Época | Modelo | Cómo buscaba | Su límite | Qué implicaba para el SEO |
| 1960-1970 | Booleano | Coincidencia exacta de palabras | Si no estaba la palabra, no existías | Repetir el término exacto o no aparecer |
| 1970-1990 | Vectorial / TF-IDF | Ponderaba las palabras: frecuentes en el documento, raras en la colección | No entendía contexto, solo contaba | Densidad de keywords como métrica central |
| 1994 | BM25 (probabilístico) | Saturaba la frecuencia y normalizaba por longitud del documento | Seguía sin comprender significado | Repetir dejaba de rendir a partir de cierto punto |
| 1998 | PageRank (Google) | Sumó al texto la autoridad que otorgan los enlaces | El enlace se podía comprar | Links y autoridad de dominio como señal clave |
| 2012 | Grafo de conocimiento | Conecta entidades y sus relaciones | Solo cubre lo que está en el grafo | Entidades, marcado semántico, Knowledge Panel |
| 2015-2021 | Modelos neuronales (RankBrain, BERT, MUM) | Representa el significado de consultas y documentos | Difícil de interpretar internamente | Intención de búsqueda por encima del término exacto |
| 2022- | LLM (ChatGPT, Perplexity, Gemini) | Genera la respuesta; con búsqueda, primero recupera fuentes y luego redacta | Puede reconstruir sin fuente | Visibilidad en la respuesta, no solo en el ranking |
Esta idea previa se transformó en una fórmula matemática con TF-IDF y, más adelante, con BM25: la relevancia de un documento no radica en repetir el término exacto, sino en el peso que tiene dentro del documento y de la colección.
Sobre esa base nació Google (inicialmente llamado BackRub). En 1998, Larry Page y Sergey Brin publicaron The Anatomy of a Large-Scale Hypertextual Web Search Engine, un paper académico que describía un motor que, además de leer el texto de las páginas y los anchor texts que apuntaban a ellas, también leía la estructura de quién enlazaba a quién. El ranking ya no dependía solo de las palabras: también dependía de la autoridad que otros sitios te otorgaban mediante sus enlaces.
«En este artículo presentamos Google, un prototipo de motor de búsqueda a gran escala que aprovecha al máximo la estructura del hipertexto. Google está diseñado para rastrear e indexar la Web de forma eficiente y ofrecer resultados de búsqueda mucho más satisfactorios que los de los sistemas existentes. El prototipo, que cuenta con una base de datos de texto completo e hipervínculos de al menos 24 millones de páginas, está disponible en http://google.stanford.edu/»
— Sergey Brin y Larry Page, The Anatomy of a Large-Scale Hypertextual Web Search Engine, 1998
Catorce años después, en 2012, Google presentó su Knowledge Graph con un lema que resume este artículo mejor que cualquier párrafo mío: things, not strings. Cosas, no cadenas de caracteres. Y finalmente llegaron los modelos neuronales, que dejaron de buscar palabras para empezar a buscar significados. Ese es el salto que hace posible que hoy un LLM entienda una pregunta mal formulada o con poco contexto.
Si el buscador aprendió a leer entidades, la investigación que alimenta nuestro contenido también debería empezar por ellas.
Keyword research basado en entidades y NLP
Las herramientas de SEO tradicionales siguen siendo indispensables para conocer la demanda y la competencia de un término en el mercado. Lo que no ofrecen es una estructura jerarquizada del conocimiento: entregan términos relacionados, pero no una arqueología del tema, ese mapa de capas que explica de qué está hecho un saber y cómo se ordena.
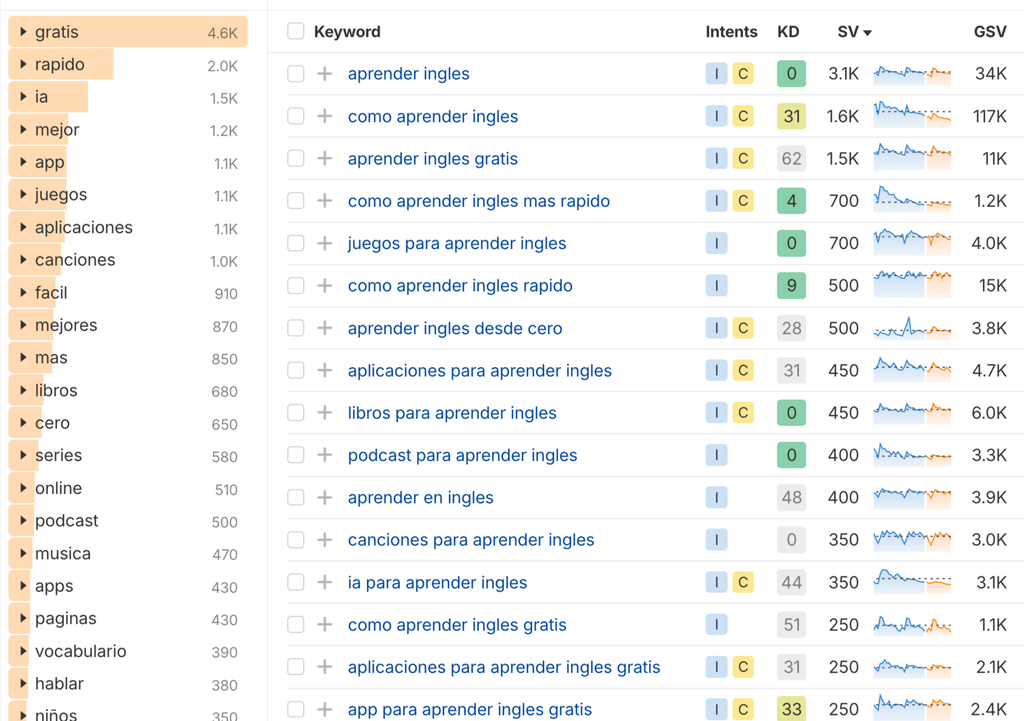
Tomemos la búsqueda «aprender inglés» en el Keyword Explorer de Ahrefs para Colombia. La herramienta nos devuelve:
- Qué tan competitivo es el término (Keyword Difficulty).
- La cantidad promedio de búsquedas mensuales: 3.100.
- El costo promedio de publicitarlo en plataformas pagas: 0,20 USD por clic.
- Un Parent Topic: «curso inglés».
Ese último dato engaña. Uno tendería a leer el Parent Topic como el término superior de una jerarquía semántica, pero no lo es: Ahrefs lo calcula a partir de la keyword que más tráfico le trae a la página que rankea primero. Es un criterio de tráfico, no de significado. Que «aprender inglés» dependa de «curso inglés» dice mucho sobre quién domina la SERP y casi nada sobre cómo se organiza el conocimiento del aprendizaje de lenguas.
Aquí aparece la distinción que sostiene el resto de este artículo. Una keyword es una consulta: lo que el usuario escribe. Una entidad es una cosa del mundo que el buscador reconoce, con identidad propia y relaciones con otras cosas: el idioma inglés, el Marco Común Europeo de Referencia, el TOEFL, el British Council. «Aprender inglés» no es una entidad. Pero está hecha de entidades.
“Conceptualmente hablando, una entidad es aquello identificado como único (una idea, un lugar, una persona, una organización) y cuyas características la ubican dentro de una categoría, pero que, a su vez, la distinguen de todas las demás dentro de ella (su categoría). Para Google , una entidad es un “referente” que ha sido reconocido y catalogado junto con otras entidades en un grafo de conocimiento. En contraste, para los grandes modelos de lenguaje (LLM), un LLM “construye” la entidad a partir de lo dicho sobre ella”.
David Martínez Mata, director de SEO y GEO de Los Creativos.
El keyword research clásico se queda en la consulta y la multiplica en variaciones: «aprender inglés gratis», «aprender inglés rápido», «aprender inglés desde cero». El research por entidades se pregunta otra cosa: ¿de qué está hecha esta consulta? Y para responderlo, usa una disciplina que lleva décadas enseñando a las máquinas a leer: el procesamiento del lenguaje natural.
«…el named entity recognition (NER) se ha utilizado con mayor frecuencia en aplicaciones de búsqueda. Una entidad nombrada es una palabra o secuencia de palabras que se utiliza para referirse a algo de interés en una aplicación concreta. Los ejemplos más comunes son los nombres de personas, los nombres de empresas u organizaciones, las ubicaciones, las expresiones de hora y fecha, las cantidades y los valores monetarios. Es fácil pensar en otras «entidades» que podrían ser importantes para aplicaciones específicas. Para una aplicación de comercio electrónico, por ejemplo, el reconocimiento de nombres de productos y números de modelo en páginas web y reseñas sería esencial. En una aplicación farmacéutica, el reconocimiento de nombres de medicamentos, dosis y afecciones médicas puede ser importante.»
— W. B. Croft, D. Metzler y T. Strohman, Search Engines: Information Retrieval in Practice, Pearson, 2009 (edición en línea, 2015)
Para este ejercicio usé SpaCy, una librería de Python de código abierto para NLP, con su modelo en español. De todo lo que SpaCy sabe hacer, aquí interesan dos cosas, y no son lo mismo:
- Entidades nombradas (doc.ents). El modelo en español las clasifica en cuatro tipos: personas (PER), lugares (LOC), organizaciones (ORG) y miscelánea (MISC). Sirven para detectar la capa de autoridad de un tema: quién lo certifica, quién lo enseña, dónde ocurre.
- Sintagmas nominales (doc.noun_chunks). Son grupos de palabras que funcionan como sustantivos: «hablantes nativos», «lengua inglesa», «inmersión lingüística». No son entidades en sentido estricto, pero son los conceptos del dominio, y para un keyword research son a menudo más útiles que las propias entidades.
¿Qué aparece al leer «aprender inglés» en cuatro fuentes?
Para poner a prueba la idea, armé una pequeña cadena de scripts en Python. Ninguno es sofisticado; lo interesante es lo que surge al leerlos juntos. Cada capa responde a una pregunta distinta sobre la misma consulta.
| Fuente | Pregunta | Lo que encontró |
| Ahrefs | ¿Cuánto se busca? | 12.800 keywords asociadas en Colombia; el 94 % marca volumen cero. Los modificadores que más se repiten: gratis, rápido, fácil, app. |
| Wikipedia + SpaCy | ¿De qué está hecho el tema? | Conceptos: bilingüismo, hablantes nativos, lengua inglesa, nivel, prueba, islas británicas. Organizaciones: British Council, Universidad de Cambridge, IDP. |
| Wikidata | ¿Qué cosa es cada una? | Q1860 (idioma inglés), Q221385 (MCER), Q487425 (TOEFL), Q490396 (IELTS), Q2918660 (Duolingo). «Cambridge English» devolvió un diccionario de pronunciación: el nombre no basta. |
| OpenAlex | ¿Cómo se ordena ese saber? | De 125 trabajos académicos: Social Sciences (111) › Arts and Humanities (85) › Language and Linguistics (83) › EFL/ESL Teaching and Learning (81). |
Nivel 1: Buscando en Ahrefs para saber la cantidad de búsquedas de este término
El informe de palabras clave relacionadas con «aprender inglés» para Colombia en Ahrefs devuelve 12.800 resultados. Detrás de esa cifra hay un paisaje bastante menos abundante:
- 12.024 de las 12.800 keywords (94 %) tienen un volumen de búsqueda estimado de cero.
- Las 100 primeras concentran el 66 % del volumen total; las 20 primeras, el 43 %.
- Los modificadores más repetidos no son conceptos, sino promesas: gratis aparece en 1.417 keywords, seguido de niños, rápido, fácil, juegos, canciones y app.
El informe de preguntas confirma la tendencia: 2.166 preguntas, de las cuales 2.003 (92 %) registran volumen cero y solo seis superan las 100 búsquedas mensuales. Las que se llevan el volumen son variaciones de la misma ansiedad: «cómo aprender inglés más rápido» (700), «cómo aprender inglés rápido» (500), «cómo aprender inglés gratis» (250), «cómo aprender inglés rápido y fácil» (150).
Nivel 2: ¿De qué está hecho el tema? Wikipedia y SpaCy
El primer ejercicio realizado en Ahrefs es el de acercamiento tradicional. Sin embargo, hemos desarrollado internamente en Los Creativos varios aplicativos y scripts en Python que nos permiten conectarnos a bases de datos para comprender en profundidad cómo abordar un tema.
El primer script que utilizamos consulta la API de Wikipedia en español y guarda el resumen de los artículos relacionados con la consulta: Idioma inglés, Inglés británico, Inglés estadounidense, Bilingüismo, Inmersión lingüística, Marco Común Europeo de Referencia, TOEFL, IELTS, British Council, Cambridge English y Duolingo. Además, busque también «Adquisición de segundas lenguas», que no existe con ese título en la Wikipedia en español, y ese vacío también es un dato.
Luego, SpaCy lee esos textos y realiza dos tareas distintas en cada uno.
El primero es el reconocimiento de entidades nombradas (NER, por sus siglas en inglés): detecta los nombres propios del texto y los clasifica. El modelo en español usa cuatro etiquetas:
- PER (persona): nombres de personas, como Jorge Luis Borges.
- LOC (lugar): países, ciudades y regiones, como Reino Unido, Londres o Australia.
- ORG (organización): empresas, instituciones y organismos, como el British Council o la Universidad de Cambridge.
- MISC (miscelánea): cualquier nombre propio que no encaje en las tres categorías anteriores, como exámenes, obras, eventos o productos. Aquí cayeron el IELTS y el Oxford English Dictionary.
El segundo es la extracción de sintagmas nominales: los grupos de palabras que funcionan como sustantivos en la oración, como «hablantes nativos», «lengua inglesa» o «inmersión lingüística». A cada uno le quité los artículos y las palabras vacías («el», «de», «una») y conté cuántas veces aparecía en el conjunto de textos. Lo que queda es una lista de conceptos, ordenada por la frecuencia con la que la enciclopedia los utiliza para explicar el tema.
El resultado, ordenado por frecuencia:
| Tipo | Lo que encontró SpaCy |
| Conceptos más frecuentes | inglés (9), idioma inglés (7), Reino Unido (4), bilingüismo (4), prueba (3), hablantes nativos (2), nivel (2), lengua inglesa (2), islas británicas (2), lenguas indoeuropeas (1) |
| Organizaciones (ORG) | British Council, Universidad de Cambridge, IDP |
| Lugares (LOC) | Reino Unido, Inglaterra, Gran Bretaña, Estados Unidos, Australia, Irlanda, Londres |
| Miscelánea (MISC) | International English Language Testing System, Oxford English Dictionary, Duolingo |
SpaCy también se equivoca: etiquetó «Además» como un lugar y «Sin embargo, el» o «Como estándar» como entidades misceláneas. Son palabras con mayúscula al inicio de una oración que el modelo confunde con nombres propios. El NLP no reemplaza el criterio del especialista; le ahorra la parte mecánica para que ese criterio se concentre en lo que importa.
Nivel 3: ¿Qué es cada entidad? El scraping de Wikidata como base de conocimiento estructurada
El segundo script busca cada término en Wikidata, la base de conocimiento estructurada de la que se nutren, entre otros, los grafos de conocimiento. Cada entidad tiene un identificador estable, el Q-ID, que permite saber que hablamos de la misma cosa en cualquier idioma y en cualquier fuente:
| Entidad | Q-ID | Descripción en Wikidata |
| English | Q1860 | West Germanic language |
| Common European Framework of Reference for Languages | Q221385 | language assessment rubric |
| TOEFL | Q487425 | examination to certify skill in English for non-native speakers |
| IELTS | Q490396 | Test for learners of English as a second language |
| British Council | Q45433 | British organisation specialising in international cultural and educational opportunities |
| Duolingo | Q2918660 | American online platform for language learning |
Aquí apareció el error más instructivo de todo el ejercicio. La búsqueda «Cambridge English» no devolvió la institución que certifica el inglés, sino English Pronouncing Dictionary, 17th ed., un diccionario de pronunciación. El script toma el primer resultado, y el primer resultado era otra cosa.
Es exactamente el problema que enfrenta un buscador cada vez que lee un nombre: el nombre no basta, hay que confirmar a qué entidad apunta. Lo que para nosotros es un error de script, para Google y para un LLM es el trabajo de todos los días, y nuestro contenido puede facilitarlo o dificultarlo.
Nivel 4: ¿Cómo se ordena ese saber según las investigaciones y la experticia? El análisis y extracción de datos de OpenAlex
El tercer script consulta OpenAlex, un catálogo abierto de cientos de millones de trabajos académicos, con cinco búsquedas en inglés: second language acquisition, English as a foreign language, English language teaching, bilingualism y language proficiency testing. Recuperé los 25 trabajos más relevantes de cada una: 125 en total.
OpenAlex clasifica cada trabajo en cuatro niveles. Esta es la jerarquía que dibujan esos 125 trabajos:
Social Sciences (111 de 125)
─ Arts and Humanities (85)
─ Language and Linguistics (83)
─ EFL/ESL Teaching and Learning (81)
Esa es, precisamente, la arqueología que le falta al tópico principal. En Ahrefs, «curso inglés» y sus términos relacionados nos permiten saber “lo que se posiciona” o lo que buscan los usuarios, pero las comunidades académicas ven un campo con ramas propias: educación multilingüe y política lingüística (13 trabajos), neurobiología del lenguaje y el bilingüismo (7), inteligencia artificial en la educación y aprendizaje móvil.
Las palabras clave académicas de esos trabajos van todavía más lejos: critical period hypothesis, language learning motivation, individual differences, learning strategies, high-stakes testing, university admission, CLIL, executive function, adult second language learning. Ninguna herramienta de SEO te las sugeriría como «relacionadas con aprender inglés». Y, sin embargo, cada una es una pregunta que alguien hace.
¿Qué aspectos no refleja el volumen de búsqueda?
Con las cuatro capas sobre la mesa, la pregunta es sencilla: ¿cuánto de lo que la academia considera central en el aprendizaje de una lengua aparece en la demanda medida por Ahrefs? Agrupé las 12.800 keywords por faceta del tema:
| Áreas temáticas | Keywords en Ahrefs | Volumen mensual | Keyword de mayor volumen |
| Contenidos (música, series, juegos, libros) | 2.258 | 5.170 | juegos para aprender inglés (700) |
| Apps e IA | 1.001 | 4.690 | aplicaciones para aprender inglés (450) |
| Gratis | 1.432 | 4.630 | aprender inglés gratis (1.500) |
| Método y estrategias | 490 | 990 | tips para aprender inglés (200) |
| Estudiar en el exterior | 237 | 570 | aprender inglés en el extranjero (80) |
| Niños | 728 | 400 | aprender inglés para niños (30) |
| Bilingüismo y beneficios | 170 | 240 | por qué es importante aprender inglés (90) |
| Tiempo de aprendizaje | 247 | 120 | en cuánto tiempo se puede aprender inglés (30) |
| Inmersión | 96 | 60 | intercambio para aprender inglés (20) |
| Edad y adultos | 163 | 40 | aprender inglés para adultos principiantes (10) |
| Exámenes y certificación | 118 | 40 | aprender inglés Cambridge (20) |
| Motivación («por qué no avanzo») | 23 | 0 | no puedo aprender inglés (0) |
Ahrefs mide con precisión la parte transaccional del tema: lo gratuito, las apps, los contenidos de entretenimiento. Las facetas que la investigación considera nucleares, como la edad, la motivación, la evaluación, la inmersión, casi desaparecen del mapa.
Pero desaparecer del mapa no significa no existir. Al cruzar los conceptos de OpenAlex con el informe de preguntas, aparecen escritas, palabra por palabra, por usuarios reales:
| Concepto académico (OpenAlex) | Pregunta real (Ahrefs) | Volumen mensual |
| critical period hypothesis | ¿A qué edad se puede aprender inglés? | 0 |
| adult second language learning | ¿Cómo aprender inglés siendo adulto? | 0 |
| individual differences, motivation | ¿Qué tan difícil es aprender inglés? | 30 |
| language proficiency assessment | ¿Cuántos niveles hay para aprender inglés? | 0 |
| language immersion | ¿Cómo aprender inglés como un nativo? | 0 |
| learning time | ¿Cuántas horas se necesitan para aprender inglés? | 10 |
| learning strategies | ¿Cuál es el mejor método para aprender inglés? | 30 |
| self-directed learning | ¿Cómo aprender inglés de forma autodidacta? | 20 |
| AI in education | ¿Cuál es la mejor IA para aprender inglés? | 90 |
| bilingualism | ¿Por qué es importante aprender inglés? | 90 |
Un volumen de cero no quiere decir que nadie pregunte. Detrás de ese cero hay dos razones.
La primera es que el informe solo muestra consultas que contienen la cadena «aprender inglés». Quien necesita el TOEFL escribe «TOEFL», no «aprender inglés TOEFL»; quien quiere saber qué es un B2 escribe «qué es un B2». La herramienta sigue atrapada en la cadena de caracteres, como aquellos primeros motores booleanos.
La segunda es que estas preguntas son largas, específicas y conversacionales. Cada formulación acumula muy pocas búsquedas idénticas, y por eso no llegan al umbral de lo que una herramienta puede estimar. Se parecen mucho, por cierto, a lo que la gente le escribe a ChatGPT. No tengo datos para afirmar que esas conversaciones migraron a los LLM; sí tengo claro que, si migraron, ninguna herramienta de volumen nos lo va a contar.
¿Ahora cómo se convierten las entidades en páginas o productos para una estrategia de contenidos?
De acuerdo con los tres retos planteados al inicio, aunque este ejercicio que acabamos de ver no los elimina, sí es cierto que determina la forma de abordarlos y responderlos:
1. Extraer y clasificar
Las variables de SEO de siempre (intención, dificultad, volumen, CPC) siguen sirviendo para leer la demanda, pero ya no son el único eje. A cada keyword le sumamos una pregunta previa: ¿a qué faceta del tema pertenece y qué entidades la componen? Clasificar deja de ser ordenar una lista y pasa a ser ubicar cada término en un mapa.
2. Elegir
La selección ya no parte de «cuáles tienen más volumen», sino de «qué dimensiones del tema existen y cuáles no estoy cubriendo». Con criterio de volumen, cualquier centro de idiomas en Colombia terminaría escribiendo sobre lo rápido, lo fácil y lo gratis: lo mismo que publica toda su competencia, justo donde la dificultad es mayor («aprender inglés gratis» marca 62 sobre 100). Con criterio de entidades, el mismo centro descubre territorio que nadie reclama.
3. El volumen ideal
Depende de para qué sea la página. Si la página busca tráfico, el volumen manda. Si busca autoridad, una pregunta con volumen cero que corresponde a un concepto central del dominio vale más que diez variaciones de «gratis». Es en esas páginas donde un buscador —y un LLM— decide si sabes de lo que hablas.
Traducida a una arquitectura de contenidos, la consulta semilla se convierte en una PAI y cada faceta en un clúster con sus propias entidades y preguntas:
| Página | Entidades que debe cubrir | H2 y preguntas frecuentes sugeridas |
| PAI: Aprender inglés | Idioma inglés (Q1860), MCER (Q221385), bilingüismo | ¿Qué tan difícil es aprender inglés? ¿Cuál es el mejor método? |
| Niveles y certificaciones | MCER, TOEFL (Q487425), IELTS (Q490396), British Council, Cambridge | ¿Cuántos niveles hay? ¿Qué examen necesito para estudiar en el exterior? |
| Aprender inglés siendo adulto | Hipótesis del periodo crítico, diferencias individuales | ¿A qué edad se puede aprender inglés? ¿Es tarde a los 40? |
| Cuánto tiempo toma | MCER, horas de instrucción, inmersión | ¿Cuántas horas se necesitan para pasar de A2 a B2? |
| Apps e IA para aprender | Duolingo (Q2918660), IA en la educación, aprendizaje móvil | ¿Cuál es la mejor IA para aprender inglés? ¿Sirve una app sola? |
| Bilingüismo y beneficios | Bilingüismo, función ejecutiva, educación bilingüe | ¿Por qué es importante aprender inglés? ¿Vale la pena un colegio bilingüe? |
De esta tabla salen tres decisiones:
- Las entidades van en el texto, no solo en las palabras clave. Una página sobre niveles que no nombra el MCER ni explica qué es un B2 está respondiendo a una cadena de caracteres, no al tema.
- El marcado semántico se conecta con el grafo. Los Q-ID de Wikidata pueden ir en la propiedad sameAs del schema, para que el buscador sepa sin ambigüedad de qué TOEFL o de qué Cambridge hablas. El error del script con «Cambridge English» es la mejor razón para hacerlo.
- Las preguntas de volumen cero son las FAQ y los H2. Son las que convierten una página comercial en una fuente que vale la pena citar.
¿Cómo se lleva esto a un plan de trabajo?
Lo que hice con «aprender inglés» se puede repetir con cualquier consulta. Este es el orden en que lo haría en un proyecto real, con lo que entrega cada paso:
- Definir la consulta semilla y el mercado: una consulta, un país, un idioma. Entrega: «aprender inglés», Colombia, español.
- Medir la demanda: exportar de Ahrefs los matching terms y el informe de preguntas. Entrega: dos CSV con volumen, dificultad e intención.
- Armar el corpus: elegir los artículos de Wikipedia que rodean la consulta, cubriendo cada faceta del tema y no solo una. Entrega: un JSON por artículo.
- Extraer conceptos y entidades: pasar el corpus por SpaCy y depurar a mano los errores del modelo. Entrega: una lista de entidades por tipo y de conceptos por frecuencia.
- Desambiguar: buscar cada entidad en Wikidata y revisar que el primer resultado sea el correcto. Entrega: un Q-ID verificado por entidad.
- Ubicar el tema en su jerarquía: consultar OpenAlex y leer dominio, campo, subcampo, tema y palabras clave académicas. Entrega: el árbol del tema y sus ramas secundarias.
- Cruzar facetas con demanda: agrupar las keywords de Ahrefs por faceta y marcar cuáles tienen volumen y cuáles solo preguntas. Entrega: la tabla de facetas.
- Diseñar la arquitectura: una PAI por consulta semilla y un clúster por faceta, cada uno con sus entidades y sus preguntas. Entrega: el mapa de páginas.
- Escribir con un brief por página: cada sección del artículo sabe qué tiene que explicar y de qué capa sale. Entrega: el brief y el texto.
- Marcar y medir: Schema con sameAs hacia Wikidata; seguimiento en Search Console y revisión periódica de si los LLM citan la página. Entrega: un tablero por clúster.
¿Cómo cambia un artículo al nutrirlo con este contexto?
Tomemos una de las preguntas sin volumen: «¿a qué edad se puede aprender inglés?». Con un brief armado solo desde la lista de keywords, el artículo saldría más o menos así:
- H1: Aprender inglés para adultos: tips para aprender rápido y fácil
- H2: Cómo aprender inglés rápido siendo adulto
- H2: Las mejores apps para aprender inglés gratis
- H2: Tips para aprender inglés fácil desde casa
Cuatro encabezados, la misma cadena repetida cuatro veces y ninguna respuesta a la pregunta que lo originó. Es el artículo que ya existe, multiplicado, en cientos de sitios.
Con las cuatro capas, el mismo artículo se arma de otra manera:
| Bloque del artículo | Qué desarrolla | De dónde sale |
| H1: ¿A qué edad se puede aprender inglés? | se puede a cualquier edad, y lo que cambia con los años es el camino, no la posibilidad | Ahrefs: «a qué edad se puede aprender inglés» (0), «cómo aprender inglés siendo adulto» (0) |
| H2: ¿Existe una edad límite para aprender un idioma? | Qué plantea la hipótesis del periodo crítico, de dónde viene y por qué la investigación sigue discutiéndola | OpenAlex: critical period hypothesis |
| H3: ¿Qué se pierde con la edad y qué no? | Qué aspectos de la lengua suelen asociarse a la edad de inicio (la pronunciación) y cuáles dependen más de la práctica | OpenAlex: adult second language learning |
| H2: ¿Aprende un adulto de forma distinta a un niño? | La diferencia entre adquirir y aprender una lengua, y las ventajas propias del adulto: estrategias, capacidad de análisis, objetivos claros | OpenAlex: language acquisition, learning strategies |
| H3: ¿Por qué los niños parecen aprender sin esfuerzo? | El papel de la exposición y de la inmersión, y por qué esa ventaja tiene más de contexto que de cerebro | OpenAlex: bilingual children; Wikipedia: Inmersión lingüística |
| H2: ¿Por qué cuesta más avanzar después de los 30? | Motivación, ansiedad y diferencias individuales; responde a quien siente que no avanza | OpenAlex: language learning motivation, individual differences; Ahrefs: «qué tan difícil es aprender inglés» (30) |
| H3: ¿Es más difícil aprender inglés o español? | La comparación desde el hablante de español: qué se transfiere de una lengua a otra y qué no | Ahrefs: «qué es más difícil de aprender, inglés o español» (10) |
| H2: ¿Qué nivel necesito y cuánto tiempo me toma? | Los seis niveles del MCER, de A1 a C2, con lo que se sabe hacer en cada uno | Wikidata: Q221385; Wikipedia: MCER; Ahrefs: «cuántos niveles hay para aprender inglés» (0) |
| H3: ¿Cuántas horas se necesitan para llegar a un B2? | Las estimaciones de horas de estudio por nivel, citadas de una fuente oficial, y por qué varían tanto de una persona a otra | Ahrefs: «cuántas horas se necesitan para aprender inglés» (10) |
| H3: ¿Qué examen certifica mi nivel? | TOEFL, IELTS y Cambridge: para qué sirve cada uno, quién lo emite y quién lo pide | Wikidata: Q487425, Q490396; OpenAlex: high-stakes testing, university admission |
| H2: ¿Qué método funciona mejor para un adulto? | Qué dice la investigación sobre estrategias de aprendizaje, y por qué no existe un método único | OpenAlex: learning strategies, teaching methods; Ahrefs: «cuál es el mejor método para aprender inglés» (30) |
| H3: ¿Se puede aprender inglés solo y desde casa? | El aprendizaje autodidacta: qué se puede lograr por cuenta propia y en qué punto hace falta un profesor | Ahrefs: «cómo aprender inglés en casa» (150), «de forma autodidacta» (20) |
| H3: ¿Sirve la inmersión si no puedo viajar? | Cómo recrear la exposición sin salir del país: intercambios, contenidos, conversación con nativos | Ahrefs: «aprender inglés sin viajar» (0), «intercambio para aprender inglés» (20); Wikipedia: Inmersión lingüística |
| H2: ¿Sirven las apps y la IA después de los 40? | Duolingo y los asistentes de IA como apoyo: en qué ayudan y cómo combinarlos con práctica real | Ahrefs: «IA para aprender inglés» (350), «mejor IA para aprender inglés» (90); Wikidata: Q2918660; OpenAlex: AI in education |
| H3: ¿Qué no puede hacer una app por ti? | Los límites de la práctica en solitario: la interacción, la conversación, la corrección en contexto | OpenAlex: classroom interaction, speaking skills |
| H2: ¿Qué gana un adulto al aprender inglés? | Lo profesional y lo cognitivo: qué se ha estudiado sobre el bilingüismo y la función ejecutiva | OpenAlex: executive function, bilingualism; Ahrefs: «por qué es importante aprender inglés» (90) |
| H2: Preguntas frecuentes | ¿Cómo aprender inglés como un nativo? ¿A qué edad deben aprender inglés los niños? ¿Es tarde para empezar a los 50? | Ahrefs: preguntas (las dos primeras); sugerida (la tercera) |
| Fuentes citadas | Enlaces a los trabajos académicos que sostienen cada H2 y al documento oficial del MCER | OpenAlex; Consejo de Europa |
| Firma del autor | Quién escribe y desde qué experiencia: la autoridad que el lector y el LLM buscan | El tercer factor del Aleph: quién lo dice |
La segunda versión no repite «aprender inglés» más veces; probablemente lo repite menos. Tampoco tiene más keywords. Lo que cambió es que cada sección sabe por qué está ahí y qué tiene que explicar: la demanda dice de qué se preocupa la gente, la academia dice qué hay que saber para responderle, y el grafo dice cómo nombrarlo para evitar ambigüedades. Incluso la parte transaccional (las apps, la IA) entra, pero lo hace como respuesta a una duda y no como relleno.
¿El problema fue clasificar o no comprender cómo categorizar?
Si pudiera volver a aquel febrero de 2017, frente a la pantalla del Keyword Planner y con un centro de idiomas como cliente, no me diría que dejara de clasificar. Me diría que estaba clasificando la capa equivocada. Las miles de variaciones de «aprender inglés» que me tenían atrapado en el rabbit hole eran la superficie: la manera en que la gente escribe su necesidad. Debajo estaba el tema mismo, con su forma, sus instituciones, sus debates y sus preguntas sin volumen.
Nada de lo que hice aquí requiere una herramienta de pago ni un equipo de ingenieros: son cuatro scripts cortos, tres fuentes abiertas y una librería de NLP gratuita. Lo que sí requiere es un cambio de pregunta. Ya no «¿cuánta gente busca esto?», sino «¿de qué está hecho esto, y cuánto de eso estoy explicando?».
Volvamos a Borges. El LLM es nuestro Aleph: un punto que contiene una representación de todo lo que se ha dicho, gobernada por la probabilidad, la lingüística y la autoridad. Sobre la probabilidad tenemos poco control. Sobre las otras dos, todo. Escribir con las entidades correctas, en la estructura correcta y respondiendo las preguntas que nadie mide es, hoy, la forma más directa de entrar en ese punto.
Fuentes
- Brin, S. y Page, L. (1998). The Anatomy of a Large-Scale Hypertextual Web Search Engine. Stanford University.
- Croft, W. B., Metzler, D. y Strohman, T. (2009). Search Engines: Information Retrieval in Practice. Pearson.
- Google. Guía sobre los sistemas de posicionamiento de la Búsqueda de Google.
- Evolving Information Retrieval: From Traditional Models to Emerging Paradigms. Journal of Advances in Information Technology, 2025.
- Ahrefs Keyword Explorer, «aprender inglés», Colombia. Exportado el 6 de octubre de 2026.
- OpenAlex, Wikidata, Wikipedia en español y SpaCy, consultados el 6 de octubre de 2026.
Con más de 10 años en SEO, David lidera el posicionamiento y rediseño web en Los Creativos. Su dominio del SEO técnico, la analítica y el contenido lo hace un referente del SEO en Colombia.